26
YLZK-01型人工智能与多智能体开发模型
2026/5/15

产品简介:
该开发模型背后由LLM智能体和多模态大模型驱动,实现了通过语音输入相关指令,LLM智能体进行思考后执行相应的任务(多模态任务及其他任务)的功能。
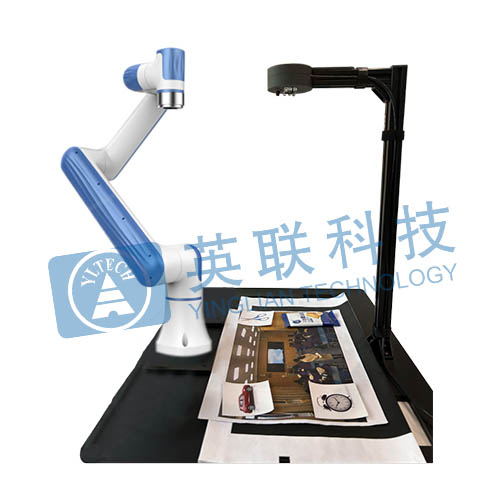
目前展台由摄像头和机械臂构成,模拟课堂教学环境,能够根据输入的指令执行人机智能交互,在实际应用中,能够帮助提高课堂教学效率。
此外,此项技术同样适用于工业生产领域,例如在车间产线进行智能装配、质量检测、仓配协同等方面;同时还可以在化工、矿山等危险环境中替代人工,以更灵活的方式满足作业需求。
技术特点:
跨模态协同学习:准确理解图像内容与相关文本,实现图文深度融合。
动态上下文解析:识别静态元素及解读复杂场景动态,实现高级场景理解。
通用泛化能力:无需针对性的训练数据,能够在各类通用环境中实现有效的对象检测和理解。
灵活的数据输入:兼容文本、图像和音频输入,增强理解和处理能力。
复杂情境适应性:适应不同需求,如识别特定人物或按要求实现对应任务。
知识迁移机制:利用跨域知识,提升新任务学习效率。